

GPU와 CPU를 물로 직접 냉각
GPU와 CPU 위에 액체 콜드플레이트를 얹어 열원을 직접 냉각합니다. CPU 트레이에는 8056 팬 4개만 남겨 보조 냉각을 맡겼습니다. 공기로 식히기 어려운 Rubin급 발열을 안정적으로 다루면서 소음과 공조 부담을 함께 낮춥니다.
INVENTEC × NVIDIA HGX RUBIN NVL8
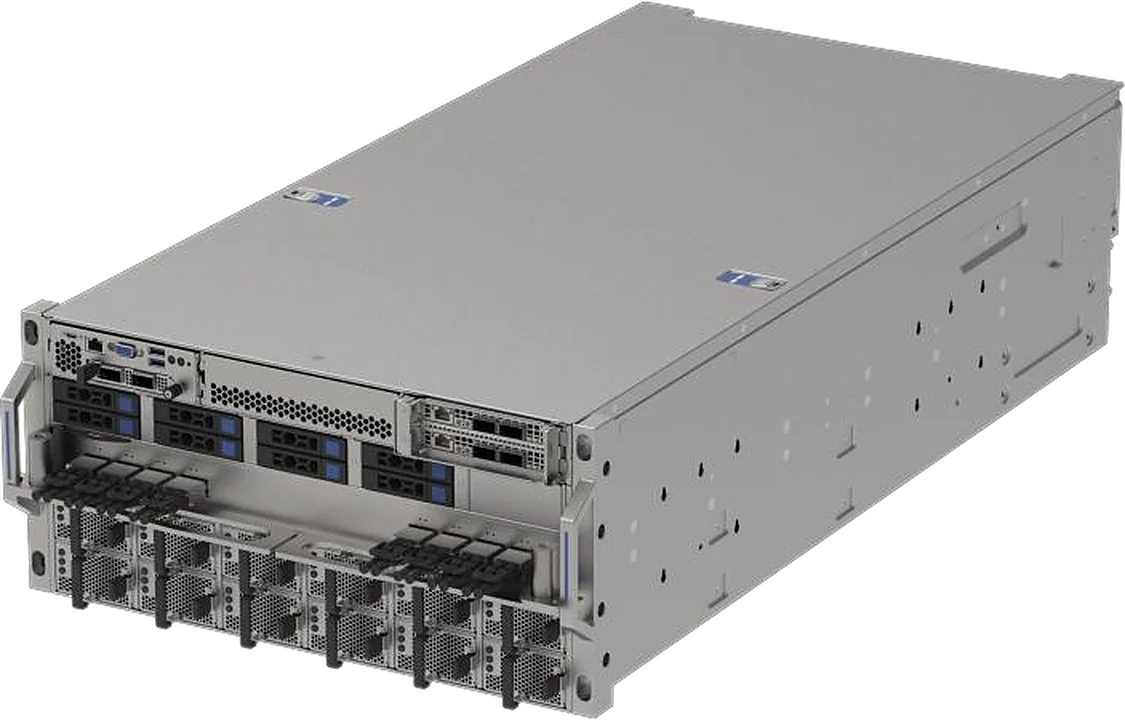
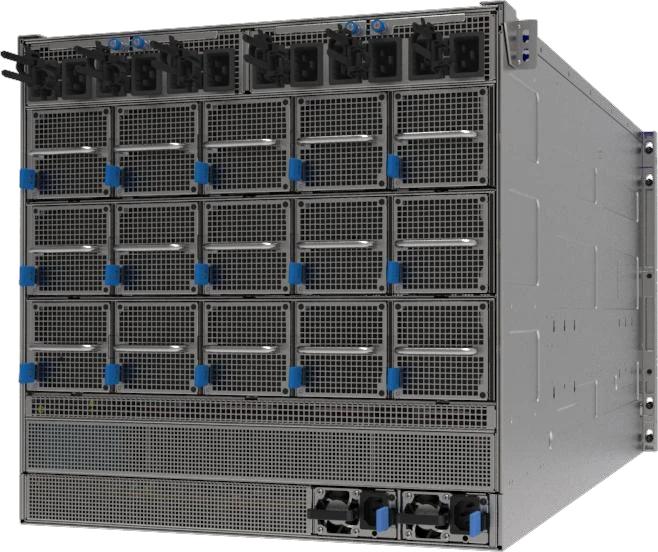
INVENTEC P5880G7 (LC)·5U 수랭식 AI 서버
2026년 1월 CES에서 NVIDIA는 Vera CPU, Rubin GPU, NVLink 6 스위치, ConnectX-9 SuperNIC, BlueField-4 DPU, Spectrum-6 이더넷 스위치까지 여섯 개의 새로운 칩을 하나로 설계한 Rubin 플랫폼을 발표했습니다. NVIDIA는 Rubin이 Blackwell 대비 추론 토큰 비용을 최대 10분의 1로 낮추고, MoE 모델 학습에 필요한 GPU 수를 4분의 1로 줄인다고 밝혔습니다. Rubin은 이미 양산에 들어갔으며, 파트너 제품은 2026년 하반기부터 공급됩니다.
에이전틱 AI와 추론 모델은 긴 문맥을 여러 단계에 걸쳐 처리하기 때문에, GPU 메모리 대역폭과 GPU 간 통신 속도가 곧 서비스 단가가 됩니다. INVENTEC P5880G7(LC)은 이 변화를 겨냥한 차세대 서버입니다. HGX Rubin NVL8 8-GPU 보드를 5U 수랭 섀시에 담고, Intel® Xeon® 6 듀얼 프로세서와 BlueField-4 DPU, GPU당 800Gb 네트워크를 결합했습니다.
이 브로슈어는 B300과의 세대 비교, 수랭 인프라 준비 조건, 그리고 B300에서 Rubin으로 이어가는 단계별 도입 전략까지 함께 담았습니다.
HGX Rubin NVL8 NVFP4 추론 성능 (8-GPU 노드)
Blackwell 대비 추론 토큰 비용 절감 (최대)
MoE 모델 학습에 필요한 GPU 수 감소
노드 GPU 메모리 대역폭 (HBM4)
자료: NVIDIA 보도자료(2026.01.05 CES, Rubin 플랫폼 발표) · NVIDIA HGX 플랫폼 사양
NVIDIA HGX Rubin NVL8을 인벤텍 수랭 설계로 감싼 차세대 플래그십 AI 서버입니다. GPU와 CPU를 콜드플레이트로 직접 냉각해, 기존 10U 공랭 서버의 절반 높이에서 세대가 다른 연산 밀도를 구현합니다.
자료: Inventec P5880G7(LC) 제품 소개서 · NVIDIA HGX Rubin NVL8 사양 · 제품 이미지 © Inventec Corp.
수랭 5U · 장단점까지
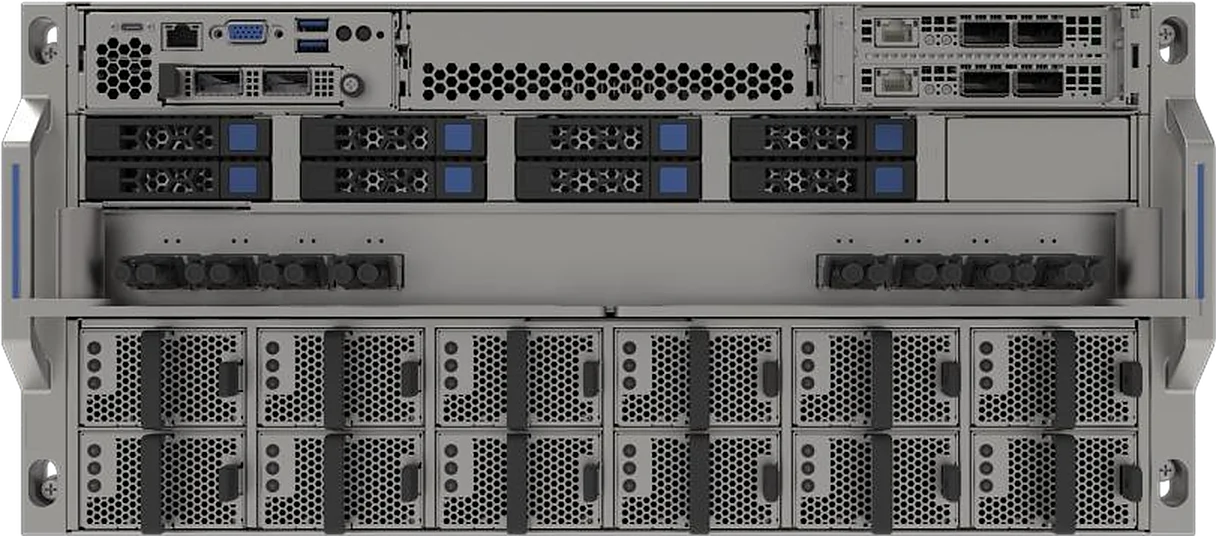 8 × U.2 SSD
GPU 트레이 · 8 × 800Gb
3,300W 54V ATS PSU
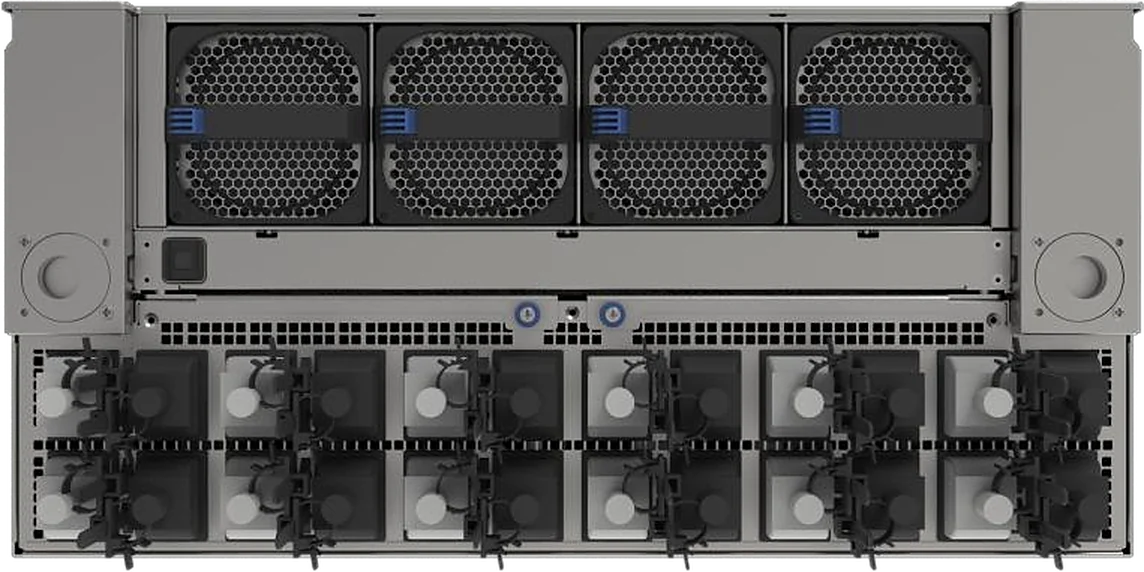 4 × 8056 팬
3,300W 54V ATS PSU
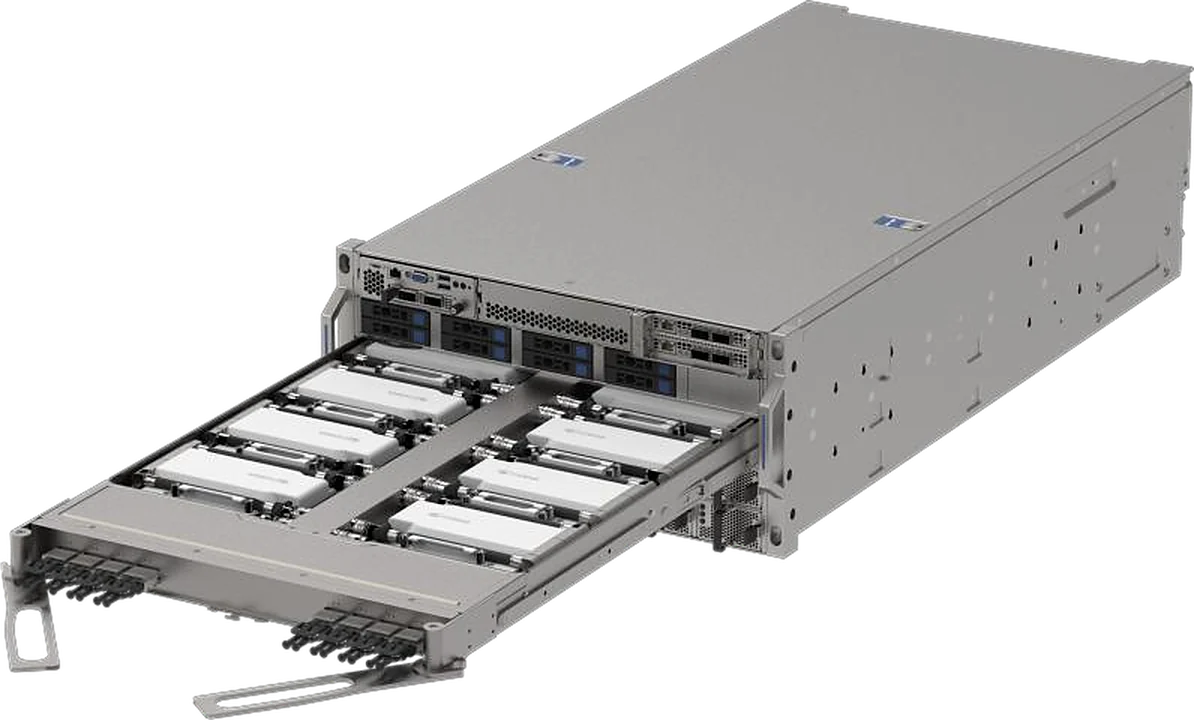
GPU와 CPU 위에 액체 콜드플레이트를 얹어 열원을 직접 냉각합니다. CPU 트레이에는 8056 팬 4개만 남겨 보조 냉각을 맡겼습니다. 공기로 식히기 어려운 Rubin급 발열을 안정적으로 다루면서 소음과 공조 부담을 함께 낮춥니다.
3,300W 54V ATS PSU를 2N 전원 구성으로 운용하며, 9+1·9+2·9+3 이중화를 지원합니다. 서로 다른 두 전원 계통 중 하나가 끊겨도 자동 절체로 가동을 이어갑니다. DPU에는 S5 상태 전원·열 관리도 지원합니다.
GPU 트레이와 CPU 트레이를 분리한 모듈형 구조로, 랙에서 트레이 단위로 인출해 점검하고 교체할 수 있습니다. 조립과 서비스 시간을 줄여 고가 GPU 자원의 다운타임을 최소화합니다.
자료: Inventec P5880G7(LC) 제품 소개서(System Overview) · 제품 이미지 © Inventec Corp.
Rubin 플랫폼은 GPU만 바꾼 세대가 아닙니다. NVLink 6가 GPU 간 대역폭을 두 배로 늘리고, ConnectX-9 SuperNIC이 GPU마다 800Gb 확장 네트워크를 연결하며, BlueField-4 DPU가 스토리지·보안·인프라 처리를 맡아 호스트 CPU의 부담을 덜어냅니다.
DDR5 32슬롯과 U.2 NVMe 최대 8(+4)베이가 대용량 학습 데이터와 체크포인트를 로컬에서 빠르게 공급합니다.
6세대 NVLink가 GPU당 3.6 TB/s로 8개 GPU를 묶어, MoE 모델의 전문가 간 통신 병목을 줄입니다.
ConnectX-9 기반 800Gb OSFP 8포트가 InfiniBand와 Ethernet 모두에서 수백 노드 클러스터로 확장합니다.
BlueField-4는 추론 KV 캐시 공유를 위한 NVIDIA 추론 컨텍스트 메모리 스토리지와 ASTRA 보안 구조를 지원해 멀티테넌트 운영을 돕습니다.
“Rubin 세대의 경쟁력은 GPU 한 장의 속도가 아니라, 여섯 개의 칩이 한 몸처럼 움직이는 시스템 설계에서 나옵니다.”
자료: Inventec P5880G7(LC) 제품 소개서 · NVIDIA 보도자료(Rubin 플랫폼, BlueField-4 · ASTRA) · NVIDIA HGX 사양
NVIDIA가 공개한 HGX B300과 HGX Rubin NVL8의 공식 사양을 같은 기준(8-GPU 노드)으로 비교했습니다. 저정밀 AI 연산뿐 아니라 메모리 대역폭, GPU 간 통신, 그리고 B300에서 줄었던 FP64 과학계산 성능까지 크게 달라집니다.
B300 대비 약 2.8배
B300 대비 약 3.9배
HBM3e → HBM4 · 약 2.75배
NVLink 5 → NVLink 6 · 2배
| 항목 | HGX B300 | HGX R200 (Rubin NVL8) | 변화 |
|---|---|---|---|
| 아키텍처 · 공정 | Blackwell Ultra · TSMC 4NP | Rubin · TSMC 3nm | 3nm 공정 전환 |
| NVFP4 추론 (Sparse) | 144 PFLOPS | 400 PFLOPS | 약 2.8배 |
| NVFP4 학습 (Dense) | 108 PFLOPS | 280 PFLOPS | 약 2.6배 |
| FP8 (Dense) | 36 PFLOPS | 140 PFLOPS | 약 3.9배 |
| FP16 / BF16 (Dense) | 18 PFLOPS | 32 PFLOPS | 약 1.8배 |
| FP64 | 10 TFLOPS | 265 TFLOPS | 과학계산 성능 회복 |
| GPU 메모리 | 2.1TB HBM3e | 2.3TB HBM4 | GPU당 288GB · HBM4 |
| 메모리 대역폭 | 약 64 TB/s | 176 TB/s | 약 2.75배 |
| NVLink | 5세대 · 14.4 TB/s | 6세대 · 28.8 TB/s | 2배 |
| 네트워크 | ConnectX-8 · 1.6 TB/s | ConnectX-9 · 1.6 TB/s | 차세대 SuperNIC |
| 시스템 전력 (참고) | 약 10~11.2kW | 약 14.4~16kW 이상 | 고밀도 수랭 필요 |
NVIDIA는 HGX Rubin NVL8이 HGX B200 대비 최대 10배의 토큰 처리량을 제공하고, 같은 학습을 4분의 1의 GPU로 끝낼 수 있다고 밝혔습니다.
근거로는 4배 많은 NVFP4 학습 연산, 1.6배 큰 고속 HBM 용량, 2배 넓은 NVLink 대역폭을 제시했습니다. 3세대 Transformer Engine은 하드웨어 기반 적응형 압축으로 추론 효율을 높입니다.
B300은 AI 저정밀 연산에 자원을 집중해 FP64가 크게 줄었습니다. Rubin은 FP64 265 TFLOPS(텐서 코어 기반 에뮬레이션 시 DGEMM 1,600 TFLOPS)를 제공해, 기상·구조해석·신약 등 배정밀도 HPC와 AI를 같은 인프라에서 운영할 수 있습니다.
자료: NVIDIA HGX 플랫폼 공식 사양(Rubin 수치는 사전 공개 사양이며 변경될 수 있음 · B300 Dense는 Sparse의 1/2 환산) · Inventec P5880G7(LC) 제품 소개서(공정 · 시스템 전력) · NVIDIA 보도자료
Rubin 세대의 8-GPU 노드는 시스템 전력이 약 14.4~16kW 이상으로 올라갑니다. 이 열을 공기만으로 처리하기는 어렵기 때문에, P5880G7은 GPU와 CPU를 콜드플레이트로 직접 냉각하는 수랭 전용 설계를 택했습니다. 도입 성패는 서버보다 먼저 냉각수·전력·랙 설계에서 결정됩니다.
노드당 시스템 전력 (참고치)
10U 공랭 대비 절반 높이
54V ATS 전원 이중화
GPU당 East-West 대역폭
자료: Inventec P5880G7(LC) 제품 소개서(냉각 · 전원 · 시스템 전력 참고치) · 랙 구성과 전력은 이해를 돕기 위한 예시이며, 실제 수량은 현장 전력·냉각 설계에 따라 결정됩니다.
Rubin 세대는 같은 전력과 공간에서 더 많은 토큰과 더 큰 모델을 처리합니다. 고객 유형별로 P5880G7이 만드는 가치를 정리했습니다.
NVIDIA는 Rubin이 MoE 모델 학습에 필요한 GPU 수를 Blackwell 대비 4분의 1로 줄인다고 밝혔습니다. GPU당 288GB HBM4와 22 TB/s 대역폭, NVLink 6의 3.6 TB/s 통신이 대형 모델의 사전학습·사후학습 시간을 단축합니다.
에이전틱 AI와 추론 모델은 긴 문맥과 여러 단계의 추론으로 토큰 사용량이 급증합니다. NVIDIA는 Rubin이 Blackwell 대비 토큰 비용을 최대 10분의 1로 낮춘다고 밝혔고, BlueField-4 기반 추론 컨텍스트 메모리 스토리지는 KV 캐시를 공유·재사용해 응답성과 처리량을 높입니다.

Rubin은 FP64 265 TFLOPS로 배정밀도 과학계산 성능을 다시 끌어올렸습니다. 공공·연구기관은 하나의 플랫폼에서 초거대 AI와 기상·재료·바이오 시뮬레이션을 함께 운영하고, 민감 데이터를 자체 인프라 안에서 처리할 수 있습니다.
자료: NVIDIA 보도자료(2026.01.05) · NVIDIA HGX Rubin NVL8 사양
| SYSTEM | |
|---|---|
| 모델 | Inventec P5880G7 (LC) |
| 폼팩터 | 5U 랙마운트 · W 448 × H 219.5 × D 875 mm (17.64 × 8.64 × 34.45 in) |
| 플랫폼 | NVIDIA HGX Rubin NVL8 · 수랭(Liquid Cooling) |
| COMPUTE | |
| 프로세서 | Intel® Xeon® 6 듀얼 소켓 — 6700 시리즈 P-core (최대 350W) |
| GPU | NVIDIA Rubin GPU × 8 · NVLink 6 · NVSwitch |
| GPU 메모리 | 총 2.3TB HBM4 (GPU당 288GB) · 176 TB/s |
| AI 연산(노드) | NVFP4 추론 400 PFLOPS · NVFP4 학습 280 · FP8 140 · BF16 32 PFLOPS · FP64 265 TFLOPS |
| 시스템 메모리 | DDR5 RDIMM 32슬롯 · 6400 MT/s @1DPC, 6000 MT/s @2DPC |
| I/O | |
| E-W 네트워크 | 8 × 800Gb OSFP · NVIDIA ConnectX-9 SuperNIC · InfiniBand / Ethernet 모드 |
| PCIe · DPU | 옵션 ① 1× FH3/4L DW (BlueField-4) ② 2× FHHL SW (BlueField-3 × 2) · 최대 800Gb/s |
| 스토리지 | 8 × U.2 NVMe 베이 (+4 옵션) · 2 × M.2 SATA/NVMe |
| POWER & COOLING | |
| 냉각 | GPU · CPU 액체 콜드플레이트 · CPU 트레이용 8056 팬 4개 |
| 전원 공급 장치 | 3,300W 54V ATS PSU · 2N 전원 · 9+1 / 9+2 / 9+3 이중화 |
| DPU 지원 | DPU용 S5 전원 및 열 관리 지원 |
| 시스템 전력 | 약 14.4~16kW 이상 (참고치) — 실소비 전력은 구성·부하별 실측 필요 |
자료: Inventec P5880G7(LC) 제품 소개서(Specifications) · NVIDIA HGX Rubin NVL8 사양(사전 공개 사양)
당사는 두 세대를 모두 공급합니다. 설치 환경과 일정에 맞춰 B300으로 바로 서비스를 열고, 수랭 인프라가 준비되는 시점에 Rubin으로 확장하는 단계별 도입을 권합니다.
현재 세대 · 공랭 10U
차세대 · 수랭 5U
세대 전환 초기에는 공급 물량이 제한적입니다. 수랭 인프라 검토와 구성 확정을 미리 진행하면 납기 협의에서 유리합니다.
자료: NVIDIA 보도자료(2026.01.05) · 연합신문망 UDN(2026.03, 인벤텍 GTC 2026 참가) · Inventec 보도자료(2026.10, OCP Global Summit)
DYNAMICS TOTAL SOLUTION다이나믹스 토탈 솔루션 주식회사다이나믹스 토탈 솔루션 주식회사(DTS)는 해온그룹(HAEON GROUP) 계열의 AI 인프라 전문 기업입니다. 당사는 대만의 AI 서버 제조사들과 제휴를 맺고 있으며, 현재 세대 B300부터 차세대 Rubin까지 GPU 서버 완제품과 메모리·스토리지·네트워크·전원 등 필수 제품을 하나의 창구에서 조달합니다. 제조 현장에서 고객의 데이터센터까지, 조달·검수·통관·정밀 물류·설치를 당사가 직접 책임집니다.
AI 인프라 그룹의 한국 사업과 장비 공급을 담당합니다.
인벤텍 등 대만 AI 서버 제조사와의 제휴로 차세대 플랫폼 물량을 확보합니다.
서버부터 수랭 · 네트워크 부품까지 한 번에 구성 · 공급합니다.
HGX Rubin NVL8 · HGX B300 8-GPU 서버, 랙 단위 시스템
Inventec · Supermicro · GigabyteDDR5 RDIMM 6400 MT/s 서버용 고용량 메모리
Micron 외U.2 / M.2 NVMe 엔터프라이즈 SSD
SanDisk · Micron 외800G OSFP 트랜시버 · 광케이블, SuperNIC · DPU
주요 네트워크 벤더CDU · 매니폴드 연계, PSU · PDU, 랙 · 레일
데이터센터 표준 부품통관 · 정밀 물류 · 보관 · 설치 · 검수
DTS와 전문 기술 업체가 직접 수행NVIDIA 발표 기준 Rubin 파트너 제품 공급 일정
가격 · 납기는 구성, 수량, 배정 물량, 설치 · 지원 범위에 따라 개별 견적으로 확정됩니다 · VAT 별도
인벤텍과의 정식 제휴로 차세대 물량 배정을 협의합니다.
CDU · 배관 · 전력까지 도입 전 현장 조건을 함께 검토합니다.
B300 즉시 가동과 Rubin 확장을 하나의 로드맵으로 설계합니다.
서버 · 네트워크 · 스토리지 · 설치를 하나의 창구로 공급합니다.
DYNAMICS TOTAL SOLUTION · HAEON GROUP 계열사
성능 수치: NVIDIA · Inventec 공개 자료 기준(Rubin 사양은 사전 공개 사양) · 제품 이미지 © Inventec Corp. · 제조사 자료: ebg.inventec.com

